Кабинет на выдуманных данных: мок из OpenAPI прямо в Vite
Личный кабинет Tuna — это Vue-приложение, которое ходит за данными в наш API по пути /v1. Чтобы открыть его локально и покликать страницы, обычно нужен поднятый бэкенд: Go-сервер, Postgres, Redis, S3, сиды. Для вёрстки это тяжело. Поэтому у кабинета есть лёгкий режим: yarn serve:mock — и dev-сервер сам отвечает на все запросы API, выдумывая данные по OpenAPI-спеке.
Никакого отдельного мок-сервера и ни одного написанного руками ответа: форму каждого ответа плагин берёт из swagger.json, а значения генерирует на лету.
yarn serve:mockподнимает кабинет без бэкенда: Vite-плагин перехватывает/v1и сам отвечает.- Форму ответа плагин берёт из OpenAPI-спеки (путь → схема ответа 200), значения генерирует по JSON Schema.
- Каждый рефреш — новый случайный, но валидный по контракту набор: разные длины списков (включая пустые), статусы, роли, тексты. Это дёшево вскрывает состояния, которые на фиксированных сидах ловишь редко.
- Побочный эффект: мок держит спеку честной. Пустая страница значит, что ручка не описана или описана не так, как отдаёт сервер.
Как это работает
Кабинет собирается на Vite. У Vite dev-сервера есть цепочка middleware (обычный connect), и плагин вешается на префикс /v1:
server.middlewares.use('/v1', (req, res, next) => {
    const spec = load();                       // swagger.json, один раз
    const reqPath = '/v1' + req.url.split('?')[0];
    const schema = responseSchema(spec, req.method, reqPath);
    // ...генерируем ответ по schema и отдаём JSON
});
Дальше всё держится на спеке. У нас сервер на Go, аннотации go-swagger превращаются в swagger.json — полную (админскую) спеку со всеми ручками. Плагин находит путь запроса (с учётом path-параметров: /v1/domains/42 матчится на /v1/domains/{id}), берёт схему ответа 200/201 и строит по ней данные.
Генерация — рекурсивный обход JSON Schema:
enum→ случайное значение из списка;- массив → 0–3 элемента (а для списков-страниц — пагинация через заголовки
x-total/x-per-page); - объект → по каждому полю;
boolean/integer/number/ строка.
Чтобы данные выглядели как настоящие, а не string string, для строк работают эвристики по имени поля:
if (n.includes('email'))     return `${pick(NAMES, k).toLowerCase()}@example.com`;
if (n.includes('avatar'))    return `https://www.gravatar.com/avatar/...`;
if (n.includes('thumbnail')) return `https://picsum.photos/seed/${k % 1000}/320/200`;
if (n.includes('url'))       return `https://${pick(WORDS, k)}.tuna.am`;
Значения считаются от индекса элемента и случайной «соли». Соль выбирается заново для каждого ответа, поэтому строки одной таблицы различаются, а при рефреше меняется весь список.
Что для этого нужно
Почти ничего, и в этом смысл. Нужна актуальная OpenAPI-спека (у нас она и так генерируется из аннотаций) и встроенный в Vite механизм middleware. Запуск — одна команда:
yarn serve:mock
Главное требование — не к инструменту, а к дисциплине: ответы API должны быть описаны в спеке. Нет описания ручки — плагину нечего генерировать, и страница приходит пустой.
Чем помогает
Кабинет открывается за секунды и где угодно. Не нужны бэкенд, база, сиды, внешние сервисы. Фронтендер, дизайнер или ревьюер открывает ветку и сразу видит интерфейс.
Каждый рефреш — другое состояние. По сути, это фаззинг интерфейса валидными по контракту данными. На фиксированных сидах граничные случаи приходится заводить руками, а здесь они всплывают сами за пару минут прокликивания:
- пустые списки и пагинация (список может оказаться на 0 строк, на одну страницу или на две);
- длинный текст в полях, где закладывались на короткий;
- все значения
enum— статусы, роли, типы — вперемешку; - необязательные поля то есть, то нет.
Спека остаётся честной. Пустая или кривая страница в моке — почти всегда сигнал, что ручка не описана или описана не так, как реально отдаёт сервер. Так мок попутно работает проверкой контракта.
Сложности подхода
Данные, валидные по схеме, запросто бывают бессмысленными, и все доработки живут ровно на этом стыке:
- Коды, которые UI превращает в названия. Поля вроде языков, ролей и локаций фронт мапит в человекочитаемые подписи. Случайная строка даёт пустые пункты в селектах — для таких полей в плагине есть точечные оверрайды с реальными кодами.
- Связанные поля. Домен с редиректом и шлюз, который этот редирект выполняет, должны согласовываться. Случайная генерация их рассинхронизирует, поэтому для доменов и шлюзов мок отдаёт заготовленные ответы с заданными состояниями строк таблицы.
- Глубина рекурсии. Генерация ограничена по глубине, иначе на циклических ссылках она бы не остановилась. Но и само ограничение дало побочные эффекты — о них ниже.
- Отсутствие состояния. Мок по спеке — это stub:
GETотдаёт свежую случайную выдумку,PATCHничего не «запоминает». Для ручек, где это важно (например, флаги просмотренных баннеров у текущего участника), мы добавили маленькое in-memory состояние на время жизни dev-сервера:PATCHпишет присланные поля,GETих накладывает. Фактически stub местами дорастает до fake.
Что мок уже выявил
- Неописанные ручки. Пустые страницы подсветили ручки, которых не было в спеке. Мы дописали к ним аннотации, и спека стала полнее.
- Описание, разошедшееся с реальностью. Один список был описан как массив, а сервер отдаёт по нему объект-словарь. Мок честно сгенерировал массив — и страница повела себя не так, как с настоящим API. Поправили описание под реальный ответ.
- Хрупкое место на фронте. Экран отчёта падал на
user.id: из-за ограничения глубины в массив попадалnull-элемент, а код перебирал список без проверки. Формально это был баг генератора (его мы и починили —null-элементы теперь отсеиваются), но заодно это сигнал: граничный ввод нашёл место, где фронт слишком доверяет данным. - Ложное срабатывание эвристики. Проверка «в имени поля есть
port» цеплялаreportsиnew_reports— и в счётчиках отчётов появлялись «порты» в диапазоне 20000–60000. Такова цена эвристик по имени поля. Проверку сузили до точного совпаденияportи суффикса_port.
Почему не взяли готовое
- Полный локальный стенд (Go-сервер + Postgres + Redis + сиды) у нас есть и остаётся основным инструментом для настоящего e2e и регресса. Но для «посмотреть вёрстку во всех состояниях» он тяжёлый: поднять, держать, пересобирать, а сиды фиксированы — редкие состояния всё равно заводить руками.
- Фикстуры или хендлеры руками (условный MSW) пришлось бы писать на каждую из сотен ручек и чинить при каждом изменении API. Мок из спеки обновляется вместе со спекой сам.
- Запись реальных ответов (record/replay) — это снимок одного состояния: ни вариативности, ни пустых списков, да ещё и с настоящими данными в дампах.
- Готовый мок-сервер по OpenAPI (вроде Prism) — хорош как отдельный сервис. Но нам нужны были доменные доводки (коды→названия, согласованные строки таблиц, stateful-ручки, фикс тарифа для гейта раздела), и хотелось обойтись без лишнего процесса: ещё один плагин в том же Vite dev-сервере, с hot-reload и данными на лету. Небольшой свой плагин оказался проще, чем тянуть и обвязывать внешний сервер.
Подход не заменяет стенд и тесты — он закрывает узкую, но частую задачу: быстро посмотреть интерфейс на разнообразных данных и заодно не дать спеке разойтись с реальностью.
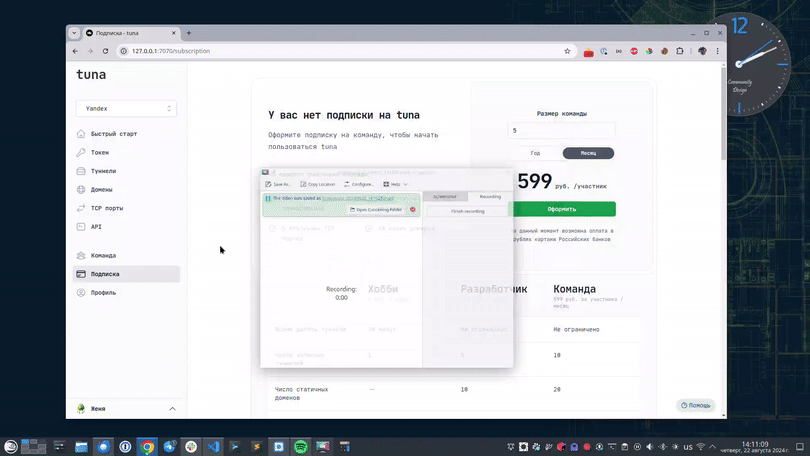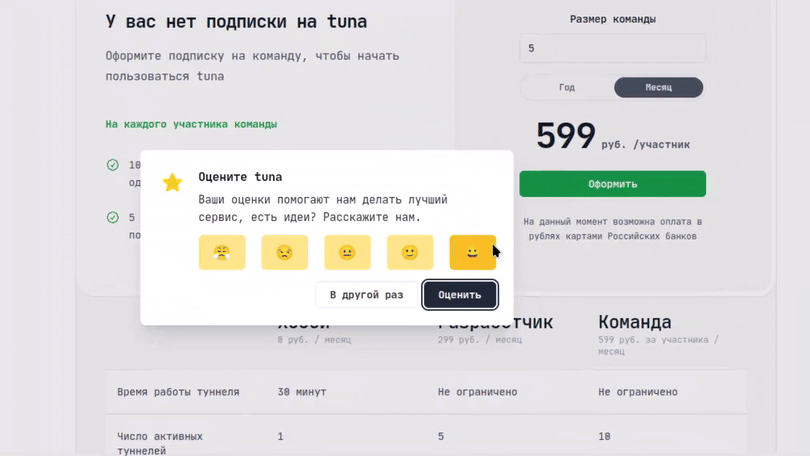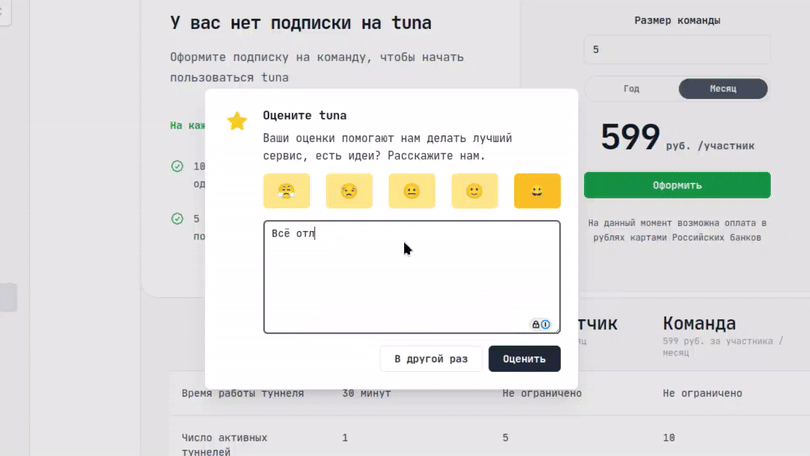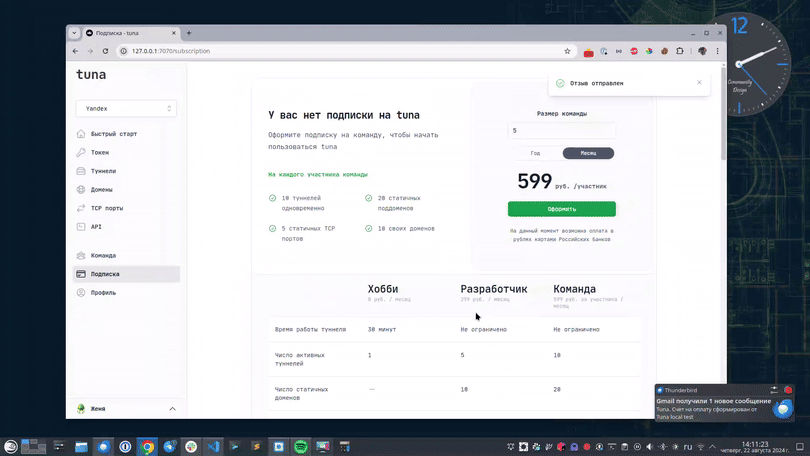
Оставьте отзыв
Если вам нравится пользоваться Tuna, или наоборот вы недовольны чем-либо, то пожалуйста оставьте отзыв.
Новости
Анонсы новых функций и статей публикуем в Telegram-канале. Подписывайтесь, чтобы ничего не пропустить.
Помощь
Мы ценим наших пользователей и детально изучаем все обращения, если у вас возникли проблемы с tuna – обязательно свяжитесь с нами одним из способов: